bytes(s::AbstractString) = collect(codeunits(s))

T = bytes("ABRACADABRA")
P = bytes("ABR")
(length(T), length(P), String(copy(P)))
(11, 3, "ABR")Capítulo 7 — Análisis de Algoritmos con Julia
Este capítulo introduce y compara algoritmos de búsqueda de patrones en cadenas de símbolos.
Al terminar este capítulo, el lector deberá ser capaz de:
La presente unidad está dedicada a los algoritmos de búsqueda de patrones en cadenas de símbolos. Antes de comenzar vamos a definir el problema.
Dado un alfabeto de símbolos \(\Sigma = \{a_1, a_2, \cdots, a_\sigma \}\) de tamaño \(\sigma\), una cadena de tamaño \(n\), \(T[1..n]\), está definida como la concatenación de \(n\) símbolos, i.e., \(T \in \Sigma^n\). Esto es, si el alfabeto es binario, \(\Sigma = \{0, 1\}\), para \(n=3\), \(T\) podría ser cualquiera de las siguientes cadenas de bits: \(\{ 000, 001, 010, 011, 100, 101, 110, 111 \}\).
Por ejemplo, la cadena \(T=\texttt{ABRACADABRA}\) está descrita por el alfabeto \(\Sigma = \{A,B,C,D,R\}\), y podemos acceder a cada uno de los símbolos mediante un subíndice, e.g., \(T_1=\texttt{A}, T_2=\texttt{B}, T_3=\texttt{R}\), etc. También se puede acceder a subcadenas haciendo uso de la notación \(T_{i:j}\), la cual obtendría una subcadena de tamaño \(j-i+1\) (concatenando los símbolos que van de \(i\) a \(j\) en \(T\)). Si \(j < i\) entonces se accede a la cadena vacía \(\epsilon\).
Es posible concatenar cadenas para obtener nuevas cadenas, por ejemplo, \(A[1..11]=\texttt{ABRACADABRA}\) y \(B[1..11] = \texttt{ARBADACARBA}\), ambas vienen del mismo alfabeto, y pueden ser concatenadas \(C[1..22] = A B = \texttt{ABRACADABRAARBADACARBA}\). De la misma forma es posible crearlas a partir de concatenar cadenas y símbolos.
Ahora, hay tres tipos de subcadenas, según su aparición dentro de otra cadena. Sean \(A, B, C\) tres cadenas de símbolos; \(D = ABC\) sería la concatenación de las tres cadenas, entonces a \(A\) se le llama prefijo de \(D\), \(C\) es llamado sufijo de \(D\) y \(B\) sería un factor de \(D\). Por ejemplo, \(\texttt{ABRA}\) es prefijo y también sufijo de \(\texttt{ABRACADABRA}\), y \(\texttt{CAD}\) es un factor.
Dada una cadena larga \(T[1..n]\) y una cadena corta \(P[1..m]\), llamada patrón, el problema consiste en encontrar todas las ocurrencias de \(P\) en \(T\), esto es, todas las posiciones \(i\) tales que \(T_{i:i+m-1} = P\). Esta operación es llamada búsqueda. Para esto se pueden tener dos variantes típicas:
Para el primer problema, se puede crear algún índice de tipo índice invertido si el texto puede ser dividido en pequeñas piezas o tokens, e.g., palabras y símbolos de puntuación en texto escrito en lenguaje natural (y con pocas propiedades aglutinantes); los capítulos anteriores cubren las operaciones sobre ese tipo de índice. De otra forma, requerirá índices sobre todas las posiciones del texto, como los árboles de sufijos o los arreglos de sufijos, que veremos al final del capítulo.
Para el segundo problema, la idea general es revisar la cadena \(T\) en ventanas de tamaño \(m\) y calcular una estructura sobre \(P\) tal que, usando la información de la ventana siendo analizada, sea posible avanzar la ventana de manera segura (sin perder ocurrencias) y rápida (moverla lo más posible). Para esto se usan los prefijos, sufijos y factores de \(P\) y de la ventana en cuestión. La mayor parte de esta unidad se enfoca en este segundo problema.
En este capítulo representaremos las cadenas como arreglos de bytes; en Julia, codeunits("ABRACADABRA") es la vista de bytes de una cadena, y collect la convierte en un Vector{UInt8}. Esto nos permite escribir algoritmos genéricos sobre AbstractVector, que funcionan igual para texto, secuencias de ADN codificadas como enteros, o cualquier otro alfabeto, y nos permite reutilizar CountingArray del Capítulo 5 para contar cuántos símbolos del texto inspecciona cada algoritmo.
bytes(s::AbstractString) = collect(codeunits(s))
T = bytes("ABRACADABRA")
P = bytes("ABR")
(length(T), length(P), String(copy(P)))(11, 3, "ABR")Los parámetros del problema son el tamaño del texto \(n\), el tamaño del patrón \(m\) y el tamaño del alfabeto \(\sigma\). Veremos que, además del peor caso, es muy informativo el costo esperado sobre un texto aleatorio donde cada símbolo se elige uniformemente de \(\Sigma\), ya que captura lo que sucede con la mayoría de las ventanas: un desajuste temprano. Mediremos el costo como el número de símbolos del texto que el algoritmo lee; los algoritmos que leen menos de \(n\) símbolos se llaman sublineales.
El algoritmo más simple compara el patrón con cada ventana del texto, símbolo por símbolo, y se detiene en el primer desajuste.
i.
2-element Vector{Int64}:
 1
 8
En el peor caso, cada ventana se compara casi completa antes de fallar; por ejemplo, con \(T = \texttt{AAAA}\cdots\texttt{A}\) y \(P = \texttt{AA}\cdots\texttt{AB}\) cada ventana cuesta \(m\) comparaciones y el total es \(\Theta(nm)\). Sin embargo, en un texto aleatorio la primera comparación de una ventana falla con probabilidad \(1 - 1/\sigma\), la segunda se alcanza con probabilidad \(1/\sigma\), la tercera con \(1/\sigma^2\), etc., por lo que el número esperado de comparaciones por ventana es \[1 + \frac{1}{\sigma} + \frac{1}{\sigma^2} + \cdots < \frac{\sigma}{\sigma - 1},\] y el costo esperado total es \(O(n)\) con una constante entre \(1\) (alfabetos grandes) y \(2\) (alfabeto binario). Esto explica por qué el algoritmo naïve es difícil de vencer en la práctica para alfabetos grandes: casi nunca lee más de un símbolo por ventana. El problema es que siempre lee al menos \(n\) símbolos; los algoritmos sublineales de las siguientes secciones rompen esta barrera.
let
    for sigma in (2, 4, 64)
        T = CountingArray(rand(Xoshiro(1), UInt8(1):UInt8(sigma), 100_000))
        P = T.data[1000:1007]
        frac = inspecciones(naive_search, T, P) / length(T)
        println("sigma = $sigma:\tinspecciones / n = $frac")
    end
end
sigma = 2: inspecciones / n = 1.99805
sigma = 4: inspecciones / n = 1.33173
sigma = 64: inspecciones / n = 1.01519Muchos de los algoritmos de búsqueda de patrones en cadenas están basados en autómatas finitos, por lo que nos remitiremos a dicha estructura.
Para nuestros propósitos, un autómata finito es una estructura discreta formada por una serie de estados \(Q\), entre los cuales hay dos tipos de estados especiales: el estado inicial \(I \in Q\) y los estados terminales \(F \subseteq Q\). Entre cada par de estados puede existir una transición, etiquetada por elementos de un alfabeto \(\Sigma \cup \{\epsilon\}\); estas transiciones son descritas de manera precisa mediante una función de transición \(\mathcal{D}(q, \alpha) = \{q_1, \cdots, q_k\}\), esto es, asocia estados \(Q\) por medio de símbolos \(\alpha \in \Sigma \cup \{\epsilon\}\). Un autómata es descrito por estas partes como \(A = (Q, \Sigma, I, F, \mathcal{D})\). Si \(\mathcal{D}\) lleva a un único estado para cada par \((q, \alpha)\) y no usa \(\epsilon\), el autómata es determinista (DFA); en otro caso es no determinista (NFA).
Considere el siguiente ejemplo, donde el texto se revisa con ventanas \(w\) del tamaño del patrón:
    1  2  3  4  5  6  7  8  9  10 11
T = A  B  R  A  C  A  D  A  B  R  A
    _______
       _______  w
          _______
             _______

P = A B R
Se creará un autómata \((\{0, 1, 2, 3\}, \{A, B, C, D, R\}, 0, \{3\}, \mathcal{D})\) donde el estado \(q\) significa “hemos reconocido el prefijo \(P[1..q]\)”. A continuación se ven dos posibles autómatas que pueden usarse para resolver las búsquedas:
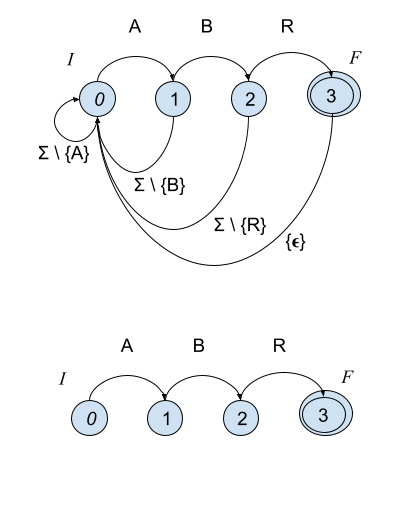
La diferencia radica en la definición de \(\mathcal{D}\). El primero puede consumir carácter por carácter de \(T\) y reportar una ocurrencia cada vez que se toque el estado \(F\) (reportar la posición en \(T\) donde ocurre); este es el autómata de un algoritmo que lee cada símbolo del texto una sola vez. El segundo hace uso del concepto de ventana; para cada ventana solo existirá un emparejamiento si iniciando en \(0\) se termina en el estado \(3\). Los algoritmos de ventana verán cómo avanzarla de manera más eficaz, leyendo los prefijos o sufijos de las ventanas, así como utilizando información de factores para mejorar el deslizamiento. Para más información, referirse a Navarro y Raffinot (2002).
Con la representación basada en autómatas es posible considerar clases de caracteres, e.g., dígitos numéricos, caracteres alfabéticos, puntuaciones, o en general conjuntos de símbolos que se deseen agrupar, así como soportar cualquier tipo de expresión regular (Navarro y Raffinot 2002).
El algoritmo KMP (Knuth et al. 1977) materializa el primer autómata de Figura 1 de forma compacta. En lugar de almacenar la tabla de transiciones completa, de tamaño \(m \times \sigma\), almacena la función de fallo \(F[q]\): la longitud del prefijo propio más largo de \(P[1..q]\) que también es sufijo de \(P[1..q]\). Cuando en el estado \(q\) el siguiente símbolo del texto no coincide con \(P[q+1]\), no hay que volver a empezar desde el estado \(0\): los últimos \(F[q]\) símbolos leídos ya coinciden con el prefijo \(P[1..F[q]]\), así que podemos pasar al estado \(F[q]\) e intentar de nuevo sin releer el texto.
function kmp_failure(P)
    m = length(P)
    F = zeros(Int, m)
1    k = 0
    for j in 2:m
2        while k > 0 && P[k+1] != P[j]
            k = F[k]
        end
        P[k+1] == P[j] && (k += 1)
        F[j] = k
    end
    F
end

function kmp_search(T, P, L=Int[])
    F = kmp_failure(P)
    m = length(P)
3    q = 0
    for i in eachindex(T)
4        while q > 0 && P[q+1] != T[i]
            q = F[q]
        end
5        P[q+1] == T[i] && (q += 1)
6        if q == m
            push!(L, i - m + 1)
            q = F[q]
        end
    end
    L
end

kmp_failure(bytes("ABRACADABRA")), kmp_search(bytes("ABRACADABRA"), bytes("ABRA"))k es la longitud del prefijo-sufijo más largo de \(P[1..j-1]\); la función de fallo se calcula aplicando el propio algoritmo al patrón contra sí mismo.
q es el estado del autómata: cuántos símbolos del patrón coinciden con el texto leído hasta ahora.
i; se sigue la función de fallo para buscar ocurrencias traslapadas.
([0, 0, 0, 1, 0, 1, 0, 1, 2, 3, 4], [1, 8])El costo de Listado 2 es \(O(n + m)\) en el peor caso, independiente de \(\sigma\). El argumento es amortizado: el estado q aumenta a lo más en uno por cada símbolo del texto, así que aumenta a lo más \(n\) veces en total; cada iteración del ciclo while disminuye q estrictamente, así que en total puede ejecutarse a lo más \(n\) veces. El mismo argumento acota el cálculo de la función de fallo por \(O(m)\). KMP es, por tanto, el primer algoritmo que garantiza tiempo lineal, pero note que siempre lee los \(n\) símbolos del texto exactamente una vez, por lo que no es sublineal.
let
    for sigma in (2, 4, 64)
        T = CountingArray(rand(Xoshiro(1), UInt8(1):UInt8(sigma), 100_000))
        P = T.data[1000:1007]
        frac = inspecciones(kmp_search, T, P) / length(T)
        println("sigma = $sigma:\tinspecciones / n = $frac")
    end
end
sigma = 2: inspecciones / n = 1.93791
sigma = 4: inspecciones / n = 1.33072
sigma = 64: inspecciones / n = 1.01526kmp_failure.q después de leer cada símbolo. ¿Cuántas veces se ejecuta el ciclo while de fallo?kmp_search hace a lo más \(2n\) comparaciones de símbolos. Construya una instancia donde se acerque a esa cota.kmp_search para que reporte únicamente ocurrencias que no se traslapen.Los algoritmos anteriores leen todos los símbolos del texto. Boyer y Moore (1977) observaron que si se compara la ventana de derecha a izquierda, el último símbolo de la ventana da información muy valiosa: si ese símbolo \(c = T[i+m-1]\) no aparece en \(P\), ninguna ventana que contenga esa posición puede ser una ocurrencia, y podemos desplazar la ventana \(m\) posiciones de golpe, sin leer los otros \(m-1\) símbolos. Si \(c\) sí aparece en \(P\), podemos desplazar la ventana hasta alinear la última ocurrencia de \(c\) en \(P[1..m-1]\) con la posición \(i+m-1\).
El algoritmo de Boyer y Moore combina esta regla con otra basada en el sufijo reconocido de la ventana; Horspool (1980) mostró que la regla del último símbolo por sí sola es casi igual de efectiva y mucho más simple. Para implementarla, se precalcula una tabla \(D\) con el desplazamiento seguro para cada símbolo del alfabeto: \[D[c] = \min\{ m - j : 1 \leq j < m,\; P[j] = c\} \quad \text{o } m \text{ si } c \text{ no aparece en } P[1..m-1].\]
function horspool_table(P::AbstractVector{UInt8})
    m = length(P)
1    D = fill(m, 256)
    for j in 1:m-1
2        D[P[j] + 1] = m - j
    end
    D
end

function horspool_search(T, P, L=Int[])
    n, m = length(T), length(P)
    D = horspool_table(P)
    i = 1
    while i <= n - m + 1
3        c = T[i+m-1]
        if c == P[m]
            j = 1
4            while j < m && T[i+j-1] == P[j]
                j += 1
            end
            j == m && push!(L, i)
        end
5        i += D[c + 1]
    end
    L
end

horspool_table(bytes("ABR"))[UInt8('A') + 1],
horspool_search(bytes("ABRACADABRA"), bytes("ABR"))c + 1; para alfabetos arbitrarios se usaría un Dict.
(2, [1, 8])El peor caso de Horspool sigue siendo \(O(nm)\), e.g., \(T = \texttt{AAA}\cdots\texttt{A}\) y \(P = \texttt{AAA}\cdots\texttt{A}\), pero su caso esperado en texto aleatorio es sublineal. Intuitivamente, con un alfabeto de tamaño \(\sigma\) y un patrón de longitud \(m\), el último símbolo de la ventana no aparece en el patrón con probabilidad aproximadamente \((1 - 1/\sigma)^{m-1}\), y en ese caso saltamos \(m\) posiciones leyendo un solo símbolo. El número esperado de símbolos inspeccionados por posición del texto es cercano a \(1/m\) cuando \(\sigma\) es grande respecto a \(m\), y a \(1/\sigma\) cuando el patrón es largo, i.e., el costo es aproximadamente \(O(n / \min(m, \sigma))\) (Navarro y Raffinot 2002, cap. 2). La siguiente tabla muestra la fracción de símbolos inspeccionados para distintos alfabetos y longitudes de patrón:
let
    println("sigma\tm=4\tm=16\tm=64")
    for sigma in (2, 4, 16, 64)
        T = CountingArray(rand(Xoshiro(1), UInt8(1):UInt8(sigma), 2^18))
        r = [round(inspecciones(horspool_search, T, T.data[1000:1000+m-1]) / length(T),
                   digits=2) for m in (4, 16, 64)]
        println("$sigma\t$(r[1])\t$(r[2])\t$(r[3])")
    end
end
sigma m=4 m=16 m=64
2 1.02 0.81 1.34
4 0.55 0.22 0.31
16 0.29 0.11 0.06
64 0.26 0.07 0.02Observe que para un alfabeto binario Horspool no gana nada, e incluso puede leer más de \(n\) símbolos: el último símbolo de la ventana casi siempre está en el patrón, los saltos son cortos y las verificaciones fallidas se acumulan. En cambio, para \(\sigma = 64\) y \(m = 64\) inspecciona alrededor del \(3\%\) del texto. Esta dependencia de \(\sigma\) y \(m\) es la característica distintiva de los algoritmos de ventana deslizante.
Las técnicas de bit-paralelismo simulan un autómata no determinista representando su conjunto de estados activos como los bits de una palabra de la computadora, de modo que una sola operación aritmética o lógica actualiza todos los estados a la vez. Si el patrón cabe en una palabra de \(w\) bits (\(m \leq w\), con \(w = 64\) en las computadoras actuales), cada símbolo del texto se procesa con un número constante de operaciones, sin importar cuántos estados tenga el autómata. Faro et al. (2012) presentan un recuento de veinte años de esta técnica.
Uno de los algoritmos más sencillos y eficientes es Shift-And (Baeza-Yates y Gonnet 1992), el cual consiste en simular el NFA de la Figura 2 usando operaciones a nivel de bits. En particular, este algoritmo es muy veloz en patrones que quepan en la palabra de la computadora; cuando el patrón es más largo, las operaciones pueden implementarse con varias palabras, teniendo en cuenta los acarreos entre ellas.
Como se había observado, es suficiente tener \(m+1\) estados para un patrón de longitud \(m\); el estado \(0\) es el inicial y tiene una transición a sí mismo con cualquier símbolo, lo que permite que una ocurrencia comience en cualquier posición. El estado \(j\) está activo después de leer \(T[1..i]\) si y solo si \(P[1..j]\) es sufijo de \(T[1..i]\), y el estado \(m\) activo indica una ocurrencia que termina en \(i\).
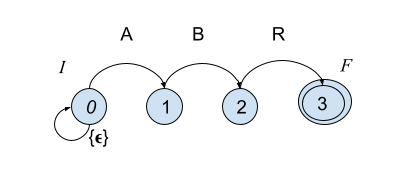
Es necesario crear la tabla \(D\) que codifica \(\mathcal{D}\): para cada símbolo \(c\) del alfabeto, \(D[c]\) es una máscara de \(m\) bits con un \(1\) en la posición \(j\) si \(P[j] = c\). Para nuestro ejemplo, la tabla quedaría como sigue (el bit menos significativo, a la derecha, corresponde al estado \(1\)):
      R  B  A      <- P reverso, para alinearlo con los bits
      3  2  1      <- estados (bit j-1)
A     0  0  1
B     0  1  0
C     0  0  0
D     0  0  0
R     1  0  0
El registro \(S\) contiene los estados activos: el bit \(j-1\) de \(S\) está encendido si el estado \(j\) está activo. Al leer el símbolo \(c\) del texto, los estados avanzan una posición (\(S \ll 1\)), el estado inicial siempre está activo (se enciende el bit \(0\) con \(\lor 1\)), y solo sobreviven los estados cuya transición está etiquetada con \(c\) (\(\land D[c]\)).
function shiftand_masks(P::AbstractVector{UInt8})
    D = zeros(UInt64, 256)
    for (j, c) in enumerate(P)
1        D[c + 1] |= one(UInt64) << (j - 1)
    end
    D
end

function shiftand_search(T, P, L=Int[])
    m = length(P)
    m <= 64 || throw(ArgumentError("el patrón debe caber en una palabra de 64 bits"))
    D = shiftand_masks(P)
    S = zero(UInt64)
2    final = one(UInt64) << (m - 1)
    for i in eachindex(T)
3        S = ((S << 1) | one(UInt64)) & D[T[i] + 1]
4        S & final != 0 && push!(L, i - m + 1)
    end
    L
end

shiftand_search(bytes("ABRACADABRA"), bytes("ABR")),
shiftand_search(bytes("MISSISSIPPI"), bytes("SS"))c tiene encendidos los bits de las posiciones del patrón donde aparece c.
<< 1), activar el estado inicial (| 1) y filtrar con el símbolo leído (& D[c]). Los tres pasos actualizan los \(m\) estados a la vez.
i.
([1, 8], [3, 6])El costo de Listado 4 es \(O(n \lceil m / w \rceil)\): para \(m \leq w\) es exactamente un número constante de operaciones por símbolo, sin ciclos internos ni ramas condicionales dependientes de los datos, lo que lo hace muy rápido y predecible en hardware moderno. A diferencia de KMP, el costo no depende de la estructura del patrón, y a diferencia de Horspool, no se beneficia de alfabetos grandes: siempre lee los \(n\) símbolos.
La variante Shift-Or usa la lógica complementaria: los bits en \(0\) representan estados activos, lo que elimina la operación | 1 del ciclo, ya que el corrimiento introduce ceros por la derecha. Es la forma en que se suele implementar en la práctica.
Una ventaja de la representación con máscaras es que la búsqueda de un patrón donde cada posición acepta un conjunto de símbolos no cuesta nada adicional: basta con encender el bit \(j\) en las máscaras de todos los símbolos de la clase \(j\). Esto permite, por ejemplo, buscar sin distinguir mayúsculas y minúsculas, o buscar A[BR]R en el sentido de las expresiones regulares.
function shiftand_masks(clases::AbstractVector{<:AbstractVector{UInt8}})
    D = zeros(UInt64, 256)
    for (j, clase) in enumerate(clases), c in clase
        D[c + 1] |= one(UInt64) << (j - 1)
    end
    D
end

function shiftand_search_masks(T, D, m, L=Int[])
    S = zero(UInt64)
    final = one(UInt64) << (m - 1)
    for i in eachindex(T)
        S = ((S << 1) | one(UInt64)) & D[T[i] + 1]
        S & final != 0 && push!(L, i - m + 1)
    end
    L
end

let D = shiftand_masks([bytes("A"), bytes("BR"), bytes("R")])   # el patrón A[BR]R
    shiftand_search_masks(bytes("ABRACADABRA ARR"), D, 3)
end
3-element Vector{Int64}:
1
8
13En Recuperación de Información es común que el patrón o el texto contengan errores: variantes ortográficas, errores de captura o de reconocimiento óptico. El problema de búsqueda aproximada consiste en encontrar las posiciones donde termina un factor del texto cuya distancia de edición al patrón sea a lo más \(k\), donde la distancia de edición cuenta el número mínimo de inserciones, eliminaciones y sustituciones de símbolos para transformar una cadena en otra. Navarro (2001) presenta una revisión detallada de este problema.
Wu y Manber (1992) observaron que Shift-And se extiende de manera natural: en lugar de un registro, se mantienen \(k+1\) registros \(R_0, R_1, \ldots, R_k\), donde el estado \(j\) de \(R_e\) está activo si \(P[1..j]\) coincide con algún sufijo del texto leído con a lo más \(e\) errores. \(R_0\) se actualiza exactamente como en Shift-And, y \(R_e\) se obtiene de cuatro fuentes: avanzar con una coincidencia desde \(R_e\), o bien usar un error adicional respecto a \(R_{e-1}\) mediante una sustitución (avanzar sin verificar el símbolo), una inserción en el patrón (no avanzar, consumir el símbolo del texto) o una eliminación (avanzar sin consumir el símbolo). Esta es la base del programa agrep.
function wumanber_search(T, P, k, L=Int[])
    m = length(P)
    D = shiftand_masks(P)
    final = one(UInt64) << (m - 1)
1    R = [(one(UInt64) << e) - one(UInt64) for e in 0:k]
    for i in eachindex(T)
        d = D[T[i] + 1]
2        prev = R[1]
        R[1] = ((R[1] << 1) | one(UInt64)) & d
        for e in 2:k+1
            actual = R[e]
3            R[e] = (((actual << 1) | one(UInt64)) & d) |
4                   prev | (prev << 1) | (R[e-1] << 1) |
                   one(UInt64)
            prev = actual
        end
5        R[k+1] & final != 0 && push!(L, i)
    end
    L
end

wumanber_search(bytes("ABRACADABRA"), bytes("ABRA"), 0),
wumanber_search(bytes("ABRACADABRA"), bytes("ABRA"), 1)prev guarda el valor de \(R_{e-1}\) antes de actualizarlo, que se necesita para la sustitución y la inserción.
prev, no avanza), sustitución (prev << 1, avanza sin verificar) y eliminación (R[e-1] << 1, con el valor ya actualizado de \(R_{e-1}\), avanza sin consumir texto).
i.
([4, 11], [3, 4, 5, 10, 11])Con \(k = 0\) el algoritmo coincide con Shift-And, salvo que reporta posiciones finales. Con \(k=1\), \(\texttt{ABRA}\) se encuentra, por ejemplo, terminando en la posición \(3\) (\(\texttt{ABR}\), una eliminación), en la \(4\) (exacta), en la \(5\) (\(\texttt{ABRAC}\), una inserción) y en la \(10\) y \(11\). El costo es \(O(k\, n \lceil m/w \rceil)\): \(k+1\) registros actualizados por cada símbolo del texto.
Shift-And es lineal porque lee cada símbolo; Horspool es sublineal porque salta. Navarro y Raffinot (2000) combinan ambas ideas en BNDM (Backward Nondeterministic DAWG Matching): se lee la ventana de derecha a izquierda, y un registro de bits mantiene el conjunto de posiciones del patrón donde el sufijo de la ventana leído hasta el momento aparece como factor. Si el conjunto se vacía, el factor leído no aparece en \(P\) y la ventana puede saltar más allá de él. Si el factor leído es además un prefijo de \(P\), se recuerda esa posición en last, ya que es la próxima alineación posible de la ventana.
function bndm_search(T, P, L=Int[])
    n, m = length(T), length(P)
    m <= 64 || throw(ArgumentError("el patrón debe caber en una palabra de 64 bits"))
    B = zeros(UInt64, 256)
    for j in 1:m
1        B[P[j] + 1] |= one(UInt64) << (m - j)
    end
    todos = m == 64 ? ~zero(UInt64) : (one(UInt64) << m) - one(UInt64)
    prefijo = one(UInt64) << (m - 1)
    i = 1
    while i <= n - m + 1
        j = m
        last = m
2        D = todos
        while D != 0
3            D &= B[T[i+j-1] + 1]
            j -= 1
4            if D & prefijo != 0
                if j > 0
                    last = j
                else
                    push!(L, i)
                end
            end
5            D = (D << 1) & todos
        end
6        i += last
    end
    L
end

bndm_search(bytes("ABRACADABRA"), bytes("ABR"))todos limita el registro a \(m\) bits para que el ciclo termine cuando se agota la ventana.
2-element Vector{Int64}:
 1
 8
BNDM tiene peor caso \(O(nm)\) como Horspool, pero su caso esperado es \(O(n \log_\sigma m / m)\), que es óptimo para búsqueda en línea (Navarro y Raffinot 2002), y es particularmente bueno con alfabetos pequeños, donde Horspool no logra saltar: el factor leído se vuelve rápidamente inexistente en \(P\) aunque cada símbolo individual sí aparezca. Observe la fracción de símbolos inspeccionados comparada con Horspool:
let
    println("sigma\tHorspool m=16\tBNDM m=16\tHorspool m=64\tBNDM m=64")
    for sigma in (2, 4, 16, 64)
        T = CountingArray(rand(Xoshiro(1), UInt8(1):UInt8(sigma), 2^18))
        r = [round(inspecciones(f, T, T.data[1000:1000+m-1]) / length(T), digits=3)
             for m in (16, 64) for f in (horspool_search, bndm_search)]
        println("$sigma\t$(r[1])\t\t$(r[2])\t\t$(r[3])\t\t$(r[4])")
    end
end
sigma Horspool m=16 BNDM m=16 Horspool m=64 BNDM m=64
2 0.81 0.347 1.34 0.117
4 0.219 0.181 0.315 0.062
16 0.11 0.109 0.062 0.034
64 0.072 0.077 0.025 0.025| 1?.* de las expresiones regulares? Consulte Navarro y Raffinot (2002).D y el salto. Compare el número de símbolos leídos con Horspool.Hasta aquí hemos medido símbolos inspeccionados, que es una medida del modelo. En la práctica importa el tiempo, y la relación entre ambos no es directa: cada algoritmo hace un trabajo distinto por símbolo, y los procesadores modernos ejecutan de forma muy eficiente los ciclos con pocas ramas condicionales y accesos secuenciales a memoria. La siguiente tabla compara los tiempos de nuestros algoritmos sobre un texto aleatorio de \(2^{20}\) símbolos, e incluye findall de Julia, la búsqueda nativa de la biblioteca estándar.
using BenchmarkTools

let
    cols = ("naive", "KMP", "Horsp.", "S-And", "BNDM", "findall")
    println(rpad("sigma", 6), rpad("m", 4), join(lpad.(cols, 9)), "  (ms)")
    for sigma in (4, 64), m in (8, 32)
        T = rand(Xoshiro(1), UInt8(1):UInt8(sigma), 2^20)
        P = T[5000:5000+m-1]
        Ts, Ps = String(copy(T)), String(copy(P))
        t = Float64[]
        for f in (naive_search, kmp_search, horspool_search, shiftand_search, bndm_search)
            tt = @belapsed $f($T, $P) seconds=0.3
            push!(t, 1000tt)
        end
        tt = @belapsed findall($Ps, $Ts) seconds=0.3
        push!(t, 1000tt)
        println(rpad(sigma, 6), rpad(m, 4), join(lpad.(string.(round.(t, digits=2)), 9)))
    end
end
sigma m naive KMP Horsp. S-And BNDM findall (ms)
4 8 3.75 3.68 1.25 0.58 1.16 1.34
4 32 3.83 3.67 1.33 0.57 0.3 1.71
64 8 1.43 1.55 0.29 0.57 0.22 0.25
64 32 1.44 1.55 0.09 0.57 0.12 0.1Varias observaciones:
Dict sería varias veces más lento, lo que ilustra que las constantes importan tanto como el orden de crecimiento.findall de Julia es muy difícil de vencer para alfabetos grandes: busca el primer y el último símbolo del patrón con instrucciones vectoriales (SIMD) que examinan 16, 32 o 64 bytes del texto en una sola operación, como hace memchr en la biblioteca de C, y solo verifica las ventanas que pasan ese filtro. Es la misma idea del bit-paralelismo, llevada a los registros vectoriales del procesador, y es la base de los algoritmos empaquetados más rápidos de la actualidad (Faro y Lecroq 2013). Con un alfabeto de \(4\) símbolos el filtro deja pasar demasiadas ventanas y los algoritmos de salto lo alcanzan.La lección general es la misma que en los capítulos anteriores: el análisis indica qué algoritmos son candidatos y cómo escalan, pero la decisión final requiere medir en la arquitectura y con los datos reales.
Dict en lugar del arreglo de 256 entradas y cuantifique la diferencia. Explique el resultado en términos del número de instrucciones por símbolo y de accesos a memoria.findall(==(P[1]), T) y verifique solo esas ventanas. Compare su tiempo con el naïve y con findall para \(\sigma = 4\) y \(\sigma = 64\), y explique cuándo funciona el filtro.Cuando el texto no cambia y se le harán muchas búsquedas, conviene preprocesarlo. El arreglo de sufijos (Manber y Myers 1993) es la estructura más simple para este fin: es la permutación \(SA[1..n]\) de las posiciones del texto que ordena lexicográficamente sus \(n\) sufijos \(T[i..n]\). Como todas las ocurrencias de \(P\) son prefijos de algún sufijo, y los sufijos que comienzan con \(P\) son contiguos en el orden lexicográfico, buscar \(P\) se reduce a localizar un intervalo de \(SA\) con dos búsquedas binarias, exactamente como en el Capítulo 5, donde cada comparación cuesta a lo más \(m\) símbolos.
function suffix_array(T)
    n = length(T)
1    sort(1:n, lt=(a, b) -> isless(view(T, a:n), view(T, b:n)))
end

2function cmp_prefix(T, i, P)
    n, m = length(T), length(P)
    for j in 1:m
        i + j - 1 > n && return -1
        T[i+j-1] == P[j] && continue
        return T[i+j-1] < P[j] ? -1 : 1
    end
    0
end

function sa_search(T, SA, P)
3    lo, hi = 1, length(SA) + 1
    while lo < hi
        mid = (lo + hi) ÷ 2
        cmp_prefix(T, SA[mid], P) < 0 ? (lo = mid + 1) : (hi = mid)
    end
    first = lo
4    hi = length(SA) + 1
    while lo < hi
        mid = (lo + hi) ÷ 2
        cmp_prefix(T, SA[mid], P) <= 0 ? (lo = mid + 1) : (hi = mid)
    end
5    first:lo-1
end

let T = bytes("ABRACADABRA")
    SA = suffix_array(T)
    println("SA = ", SA)
    println("sufijos ordenados: ", [String(copy(T[i:end])) for i in SA])
    r = sa_search(T, SA, bytes("ABRA"))
    println("ABRA ocurre en las posiciones ", sort(SA[r]))
endi; regresa \(-1\), \(0\) o \(1\).
binarysearch del Capítulo 5).
SA = [11, 8, 1, 4, 6, 9, 2, 5, 7, 10, 3]
sufijos ordenados: ["A", "ABRA", "ABRACADABRA", "ACADABRA", "ADABRA", "BRA", "BRACADABRA", "CADABRA", "DABRA", "RA", "RACADABRA"]
ABRA ocurre en las posiciones [1, 8]
El arreglo de sufijos ocupa \(n\) enteros adicionales al texto, y responde en \(O(m \log n)\) la pregunta de cuántas veces ocurre un patrón, y en \(O(m \log n + occ)\) la de dónde, donde \(occ\) es el número de ocurrencias; compare con los \(\Omega(n/m)\) símbolos que cualquier algoritmo en línea debe leer. Estructuras más sofisticadas, como el FM-index (Ferragina y Manzini 2000), comprimen el texto y el índice juntos y son la base de las herramientas de alineamiento de secuencias genómicas; para texto en lenguaje natural, el índice invertido de los capítulos anteriores sigue siendo la opción dominante.
sa_search por la búsqueda no acotada \(B_1\) del Capítulo 5 para resolver una secuencia ordenada de patrones que comparten prefijos. ¿Cuándo tiene sentido?sa_search lee para \(m \in \{4, 16, 64\}\) y \(n = 2^{16}\), y compárelo con los algoritmos en línea de la sección anterior. ¿A partir de cuántas búsquedas sobre el mismo texto se amortiza la construcción del arreglo?El libro de Navarro y Raffinot (2002) es la referencia principal de este capítulo: cubre con detalle los algoritmos de ventana deslizante, el bit-paralelismo, la búsqueda aproximada y la búsqueda de expresiones regulares, con un enfoque práctico y experimental. Los artículos originales son breves y muy legibles: Knuth et al. (1977) para el algoritmo lineal con función de fallo, Boyer y Moore (1977) y Horspool (1980) para los algoritmos de salto, Baeza-Yates y Gonnet (1992) y Wu y Manber (1992) para Shift-And, Shift-Or y la búsqueda aproximada, y Navarro y Raffinot (2000) para BNDM. Faro et al. (2012) resumen veinte años de bit-paralelismo, Fredriksson (2003) explora el uso de superalfabetos para procesar varios símbolos por paso, y Faro y Lecroq (2013) revisan y comparan experimentalmente los algoritmos de búsqueda exacta en línea de la década de 2000 a 2010, incluidos los que aprovechan instrucciones SIMD. Para la búsqueda aproximada en general, el recorrido de Navarro (2001) es la lectura obligada. Finalmente, Manber y Myers (1993) introducen el arreglo de sufijos y Ferragina y Manzini (2000) el FM-index, dos estructuras fundamentales para el escenario de texto estático.
El objetivo es comparar experimentalmente los algoritmos de búsqueda en línea del capítulo en función del tamaño del alfabeto \(\sigma\), de la longitud del patrón \(m\) y de la distribución de los símbolos del texto, midiendo por separado el número de símbolos inspeccionados y el tiempo. Todos los datos se generan con el código de Listado 8, con semillas fijas, para que todos los reportes trabajen sobre las mismas instancias; no utilice archivos externos ni cambie las semillas ni los parámetros predeterminados.
Se usan dos tipos de texto: uniforme, donde cada símbolo se elige independientemente de un alfabeto de tamaño \(\sigma\), y Zipf, un texto pseudo-natural formado por palabras de un vocabulario cuyas frecuencias siguen una ley de Zipf, separadas por espacios, que imita la distribución sesgada de los textos en lenguaje natural. Los patrones se toman del propio texto (ocurrencias garantizadas) o se generan al azar (casi nunca ocurren).
using Random

const SEMILLA = 2026

"""
    texto_uniforme(n, sigma; semilla=SEMILLA)

Texto de `n` símbolos independientes y uniformes sobre el alfabeto `1:sigma`.
"""
function texto_uniforme(n, sigma; semilla=SEMILLA)
    rng = Xoshiro(semilla)
    rand(rng, UInt8(1):UInt8(sigma), n)
end

"""
    texto_zipf(n; vocabulario=5000, s=1.0, semilla=SEMILLA + 1)

Texto de `n` bytes formado por palabras de letras minúsculas, de un vocabulario de
`vocabulario` palabras cuyas frecuencias siguen una ley de Zipf con exponente `s`.
"""
function texto_zipf(n; vocabulario=5000, s=1.0, semilla=SEMILLA + 1)
    rng = Xoshiro(semilla)
    letras = UInt8('a'):UInt8('z')
    palabras = [rand(rng, letras, rand(rng, 2:9)) for _ in 1:vocabulario]
    pesos = cumsum([1 / r^s for r in 1:vocabulario])
    T = UInt8[]
    while length(T) < n
        r = searchsortedfirst(pesos, rand(rng) * pesos[end])
        append!(T, palabras[r])
        push!(T, UInt8(' '))
    end
    resize!(T, n)
end

"""
    patrones_del_texto(T, m, cuantos; semilla=SEMILLA + 2)

`cuantos` patrones de longitud `m` copiados de posiciones aleatorias de `T`.
"""
function patrones_del_texto(T, m, cuantos; semilla=SEMILLA + 2)
    rng = Xoshiro(semilla)
    [T[s:s+m-1] for s in rand(rng, 1:length(T)-m+1, cuantos)]
end

"""
    patrones_aleatorios(sigma, m, cuantos; semilla=SEMILLA + 3)

`cuantos` patrones aleatorios de longitud `m` sobre el alfabeto `1:sigma`.
"""
function patrones_aleatorios(sigma, m, cuantos; semilla=SEMILLA + 3)
    rng = Xoshiro(semilla)
    [rand(rng, UInt8(1):UInt8(sigma), m) for _ in 1:cuantos]
end
La siguiente salida sirve como control: reproduzca estos valores con sus propios datos antes de medir nada. Si trabaja en Python, replique la lógica de los generadores; las secuencias aleatorias no serán idénticas, pero los números de ocurrencias deben ser similares.
let n = 2^20
    Z = texto_zipf(n)
    println("Zipf: ", String(copy(Z[1:60])), "...")
    println("Zipf: simbolos distintos = $(length(unique(Z)))")
    for sigma in (2, 4, 16, 64)
        T = texto_uniforme(n, sigma)
        occ = [sum(length(shiftand_search(T, P)) for P in patrones_del_texto(T, m, 20)) / 20
               for m in (4, 8, 16, 32, 64)]
        print("uniforme sigma = $(lpad(sigma, 2)): ocurrencias medias por patron ")
        println("(m = 4, 8, 16, 32, 64) = ", round.(occ, digits=1))
    end
    occ = [sum(length(shiftand_search(Z, P)) for P in patrones_del_texto(Z, m, 20)) / 20
           for m in (4, 8, 16, 32, 64)]
    print("Zipf: ocurrencias medias por patron ")
    println("(m = 4, 8, 16, 32, 64) = ", round.(occ, digits=1))
end
Zipf: ritq axu tkjycrar kbicfidvq cui bjyhmnjx eefgnrz wufdwrwa nu...
Zipf: simbolos distintos = 27
uniforme sigma = 2: ocurrencias medias por patron (m = 4, 8, 16, 32, 64) = [65425.3, 4112.4, 17.4, 1.0, 1.0]
uniforme sigma = 4: ocurrencias medias por patron (m = 4, 8, 16, 32, 64) = [4087.6, 17.3, 1.0, 1.0, 1.0]
uniforme sigma = 16: ocurrencias medias por patron (m = 4, 8, 16, 32, 64) = [17.0, 1.0, 1.0, 1.0, 1.0]
uniforme sigma = 64: ocurrencias medias por patron (m = 4, 8, 16, 32, 64) = [1.0, 1.0, 1.0, 1.0, 1.0]
Zipf: ocurrencias medias por patron (m = 4, 8, 16, 32, 64) = [2902.2, 623.6, 1.1, 1.0, 1.0]Con estos datos, realice lo siguiente:
Implementación. Implemente el algoritmo naïve, KMP, Horspool, Shift-And y BNDM. Verifique que todos producen las mismas ocurrencias que el naïve sobre instancias pequeñas aleatorias, incluyendo patrones de longitud \(1\) y patrones periódicos como \(\texttt{AAAA}\). Para contar símbolos inspeccionados puede usar CountingArray del Capítulo 5.
Datos. Genere textos uniformes de \(n = 2^{20}\) símbolos para \(\sigma \in \{2, 4, 16, 64\}\) y el texto Zipf del mismo tamaño. Para cada texto y cada \(m \in \{4, 8, 16, 32, 64\}\) genere \(100\) patrones tomados del texto y \(100\) patrones aleatorios (para el texto Zipf, use patrones_aleatorios(26, m, 100) y sume UInt8('a') - 0x01 a cada símbolo para que sean letras). Si su equipo no lo permite, reduzca \(n\) y repórtelo.
Experimentación. Para cada algoritmo, texto, longitud \(m\) y tipo de patrón, mida el número de símbolos inspeccionados y el tiempo de búsqueda; repita las mediciones de tiempo las veces necesarias para que sean fiables. Presente gráficas de caja (boxplot) con los \(100\) patrones como muestras, una gráfica por combinación de texto y \(m\), con todos los algoritmos en cada gráfica, para: tiempo, símbolos inspeccionados divididos entre \(n\), y número de ocurrencias (gráfica de control: todos los algoritmos deben coincidir).
Análisis. Discuta: ¿qué algoritmos son sublineales y cómo depende la fracción de símbolos inspeccionados de \(\sigma\) y de \(m\)? ¿Coinciden los ganadores en símbolos inspeccionados y en tiempo? ¿Hay diferencia entre patrones que ocurren y patrones que no ocurren? ¿Cómo afecta el sesgo de la distribución Zipf a Horspool y a BNDM en comparación con el texto uniforme de \(\sigma = 64\)? Concluya con una recomendación de algoritmo para cada escenario (\(\sigma\) pequeño o grande, \(m\) corto o largo).
Extensión opcional. Incluya findall de Julia en la comparación de tiempos y explique su comportamiento. Alternativamente, implemente el algoritmo de Wu y Manber y mida cómo crece su tiempo con \(k \in \{0, 1, 2, 3\}\) sobre el texto Zipf, y cuántas ocurrencias aproximadas adicionales aparecen respecto a la búsqueda exacta.
Su trabajo se entregará en PDF y con el notebook fuente, se entregará en el sistema en archivos separados. El código se debe documentar, así como mantener una estructura del documento que permita a un lector interesado entender el problema, sus experimentos y metodología, así como sus conclusiones. Tenga en cuenta que los notebooks pueden alternar celdas de texto y código.
No olvide estructurar su reporte, en particular el reporte debe cubrir los siguientes puntos:
Nota: no olvides revisar la rúbrica del curso.